Calculer avec le hasard
Les énoncés exacts et les preuves de ce que le film a montré.
Combien de tirages faut-il pour avoir raison, et comment le prouver ?
En 1946, le mathématicien Stanislaw Ulam se demande quelle chance a une réussite de bien se terminer. Le calcul exact est hors de portée ; jouer cent parties et compter ne l’est pas. Ce chapitre transforme cette idée de convalescent en méthode de calcul, et surtout en méthode vérifiable : on saura dire combien de tirages il faut, et avec quelle garantie.
Le chapitre suit le film de la séance 1, « Calculer avec le hasard » : le problème d’Ulam (Section 1.1), la loi des grands nombres (Section 1.2), le calcul d’une aire (Section 1.3), l’estimateur de Monte-Carlo et ses deux cas d’école, l’option d’achat et la ruine d’un assureur (Section 1.4), le théorème central limite et l’intervalle de confiance (Section 1.5), la dimension et les événements rares (Section 1.6).
1.1 Le problème d’Ulam#
Convalescent après une encéphalite, à Los Angeles, Ulam joue à la réussite Canfield, qui se joue seul avec 52 cartes. Il essaie de calculer la probabilité qu’une donne aboutisse ; mais le nombre d’ordres possibles du paquet est 8,07, et aucune énumération n’est envisageable. Il imagine alors d’étaler « disons cent fois » le jeu et de compter les succès (Eckhardt 1987). Avec John von Neumann, il comprend aussitôt que la même idée vaut pour la diffusion des neutrons à Los Alamos : un problème aux dimensions innombrables, où l’on peut remplacer une équation par une suite d’opérations aléatoires. Le nom de code, « Monte-Carlo », est proposé par Nicholas Metropolis en souvenir d’un oncle d’Ulam qui empruntait à ses proches pour aller jouer au casino (Metropolis 1987) ; le premier article sur la méthode paraît en 1949 (Metropolis et Ulam 1949).
La question à garder en tête : combien de parties Ulam devait-il jouer pour connaître sa chance à 1 % près ? Elle reçoit sa réponse à la Section 1.5.
1.2 Une probabilité est une proportion#
1.2.1 Le cadre#
On travaille sur un espace probabilisé . Une variable aléatoire réelle est une fonction mesurable de dans ; sa loi est la mesure image .
Des variables forment un échantillon (ou suite i.i.d.) de loi si elles sont indépendantes et ont toutes la loi . Simuler , c’est produire sur ordinateur des réalisations d’un tel échantillon.
Une probabilité est une espérance : pour tout événement , , et si . Estimer une probabilité, c’est donc estimer la moyenne d’une variable qui vaut 1 ou 0 : la proportion de succès parmi essais.
1.2.2 Dix lancers : l’exact devient rare#
Sur dix lancers d’une pièce équilibrée, le nombre de faces suit la loi binomiale . Il y a suites sur 1 024 qui donnent exactement cinq faces : 24,6 % seulement. Six faces et quatre piles, ou l’inverse, arrive 41 % du temps. La vidéo commence sur six faces et quatre piles : rien d’anormal.
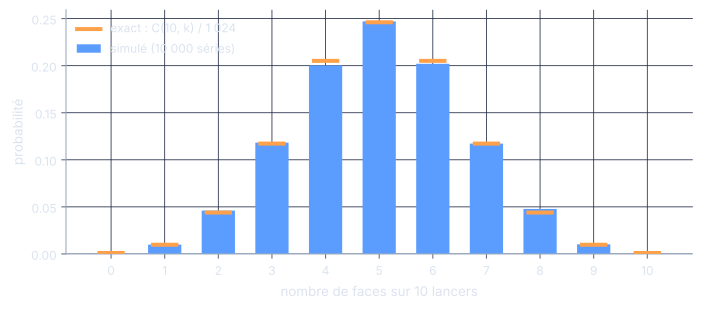
La simulation de 10 000 séries donne 2 470 séries à cinq faces, soit 24,70 % ; les barres bleues se posent sur les marques orange. Plus grandit, plus « exactement la moitié » devient improbable, mais plus « à peu près la moitié » devient certain : c’est ce que dit la loi des grands nombres.
1.2.3 La loi des grands nombres#
Si , alors pour tout , .
Démonstration
L’inégalité est vraie point par point ; on prend l’espérance.
Soit un échantillon avec , et . Alors la moyenne empirique vérifie, pour tout ,
Démonstration
Par linéarité, ; par indépendance, les variances s’ajoutent : . On applique la Proposition 1.1 à .
La loi faible dit que l’erreur est rarement grande ; la loi forte dit que la suite des estimations, celle que l’on voit se stabiliser sur un écran, converge.
Si est un échantillon avec , alors presque sûrement.
Démonstration
On démontre l’énoncé sous l’hypothèse plus forte , qui suffit pour tout ce cours ; le cas général demande une troncature (Etemadi 1981; Durrett 2019). Quitte à remplacer par , on suppose . Notons . En développant , les termes qui contiennent un à la puissance 1 sont d’espérance nulle par indépendance ; il reste L’inégalité de Markov donne , terme général d’une série convergente. Par le lemme de Borel-Cantelli, presque sûrement à partir d’un certain rang. On conclut en prenant , (intersection dénombrable d’événements presque sûrs).
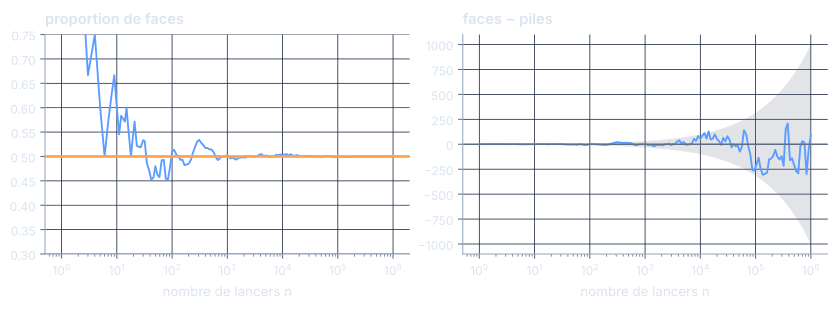
Appliquée à , la loi forte dit que la proportion converge vers : une probabilité est une proportion, à la limite. Dans la vidéo, la proportion de faces vaut 50,28 % après 10 000 lancers et 50,005 % après un million.
Démonstration
Le hasard ne compense pas. L’écart entre le nombre de faces et le nombre de piles, , est centré de variance : il ne tend pas vers 0, il grandit typiquement comme (dans la vidéo, il vaut +94 après un million de lancers). Par le théorème central limite (Section 1.5), . Mais : divisé par , l’écart s’écrase et la proportion converge. L’« erreur du joueur », qui croit qu’après une série de piles la face est « due », confond ces deux échelles : la pièce n’a pas de mémoire, les écarts ne sont pas corrigés, ils sont dilués (Tversky et Kahneman 1974).
1.2.4 Simuler sur ordinateur#
Un ordinateur ne lance pas de pièce : il calcule une suite de nombres par une récurrence déterministe, dont les propriétés statistiques imitent celles d’un échantillon uniforme. NumPy utilise l’algorithme PCG64 (O’Neill 2014) : np.random.default_rng(graine) crée un générateur, et la même graine redonne la même suite. Le code de la vidéo, exécuté ici :
rng = np.random.default_rng(2)
faces = rng.random(1_000_000) < 0.5
print(faces.mean())0.500047Tout le reste se construit à partir de l’uniforme. L’outil de base est l’inversion de la fonction de répartition.
Soit une fonction de répartition et son inverse généralisée. Si suit la loi uniforme sur , alors a pour fonction de répartition .
Démonstration
est croissante et continue à droite, donc l’ensemble est un intervalle fermé . Ainsi , et .
Pour la loi exponentielle de moyenne , et . Ce sont ces tirages que l’on utilisera au chapitre suivant pour le « jumeau » de l’assureur : deux lois différentes obtenues à partir des mêmes uniformes. Pour la loi normale, NumPy utilise un algorithme plus rapide que l’inversion (rng.standard_normal).
1.3 Une aire se compte#
Soit uniforme sur le carré . Pour toute partie mesurable du carré, . Avec le quart de disque , d’aire : où est le nombre de points, parmi , qui tombent dans le quart de disque. C’est la loi forte des grands nombres appliquée à une indicatrice : une aire se compte.
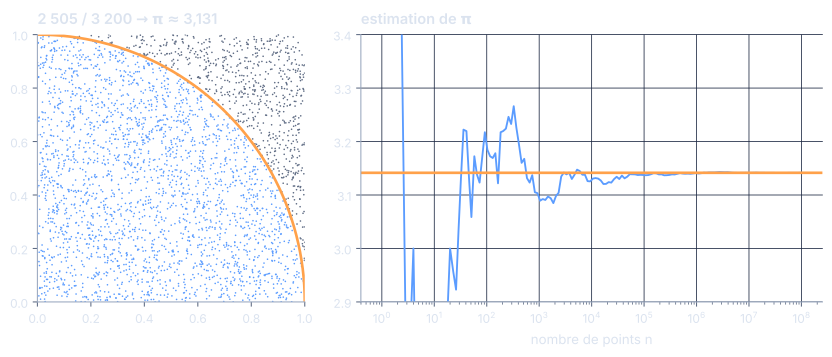
Sur les 3 200 fléchettes de la vidéo, 1 582 tombent sous la diagonale (49,4 %, pour une aire de ½) et 2 505 dans le quart de disque : 3,131. Avec , et points, l’estimation vaut 3,1256, 3,1405 et 3,1415 : chaque décimale coûte environ cent fois plus de points que la précédente. La Section 1.5 explique pourquoi.
Plus généralement, toute intégrale sur le cube unité est une espérance : avec uniforme sur . C’est le point de départ de l’intégration numérique par Monte-Carlo.
Buffon pose en 1733, et publie en 1777, le problème suivant (Buffon 1777) : une aiguille de longueur tombe au hasard sur un parquet dont les rainures sont espacées de ; quelle est la probabilité qu’elle coupe une rainure ? Notons la distance du centre à la rainure la plus proche, uniforme sur , et l’angle avec les rainures, uniforme sur , indépendants. L’aiguille coupe une rainure si et seulement si , d’où Laplace retourne la question en 1812 (Laplace 1812) : lancez aiguilles, comptez les croisements, et estime . (Une expérience célèbre de 1901 annonçait six décimales justes avec 3 408 aiguilles : un résultat presque certainement obtenu en s’arrêtant au bon moment, ce qui est exactement ce qu’un intervalle de confiance interdit.)
1.4 Une espérance est une moyenne#
1.4.1 L’estimateur de Monte-Carlo#
Soit une variable aléatoire à valeurs dans , mesurable avec , et . Pour un échantillon de même loi que , l’estimateur de Monte-Carlo est
C’est la formule de la vidéo, lue symbole par symbole : le hasard (le dé, la pièce, le prix d’une action demain), ce qu’on regarde dans ce hasard (un nombre affiché, un gain, une perte), la moyenne à long terme qu’on cherche, les tirages de l’ordinateur ; on additionne et on divise par . La moyenne cherchée est à peu près la moyenne de ce qu’on observe en simulant.
- est sans biais : ; il est fortement consistant : p.s. (Théorème 1.2).
- Si de plus et , alors : l’erreur typique (écart-type de l’estimateur) vaut .
Démonstration
Linéarité de l’espérance, loi forte appliquée aux , qui sont i.i.d. et intégrables, et additivité de la variance pour des variables indépendantes.
Pour un dé équilibré, , une valeur qu’aucun lancer ne donne ; la moyenne de 10 000 lancers simulés vaut 3,5088.
def monte_carlo(Y):
    """Estimation et demi-largeur de l'intervalle de confiance asymptotique à 95 % à partir des tirages Y = f(X_i)."""
    Y = np.asarray(Y, dtype=float)
    return Y.mean(), 1.96 * Y.std(ddof=1) / np.sqrt(len(Y))
1.4.2 Cas de finance : l’option d’achat#
Une option d’achat européenne (un call) de prix d’exercice et d’échéance donne le droit, sans obligation, d’acheter l’action à la date au prix . Son gain à l’échéance est . La théorie de l’évaluation par arbitrage (cours de calcul stochastique) établit que son prix aujourd’hui est l’espérance du gain actualisé sous la probabilité risque neutre : Dans le modèle de Black et Scholes (Black et Scholes 1973; Merton 1973), le prix suit un mouvement brownien géométrique et, sous , avec , où est le taux sans risque et la volatilité (l’écart-type annuel des rendements). Le prix est une espérance : on peut le simuler (Boyle 1977). Pour ce cas simple, on connaît aussi la valeur exacte, qui servira de juge.
Si avec et , alors
Démonstration
. D’une part . D’autre part, en notant la densité de , on vérifie en complétant le carré que ; donc avec , soit .
Avec et , on obtient , avec et .
Pour , , , an, le juge vaut 10,4506 €. Le code suivant simule un million d’avenirs :
S0, K, r, sig, T = 100.0, 100.0, 0.05, 0.20, 1.0
rng = np.random.default_rng(1973)
Z = rng.standard_normal(1_000_000)
ST = S0 * np.exp((r - sig**2 / 2) * T + sig * np.sqrt(T) * Z)
prix, demi = monte_carlo(np.exp(-r * T) * np.maximum(ST - K, 0))
print(f"Monte-Carlo : {prix:.3f} ± {demi:.3f}   |   Black-Scholes : {bs_call(S0, K, r, sig, T):.4f}")
Monte-Carlo : 10.426 ± 0.029 | Black-Scholes : 10.4506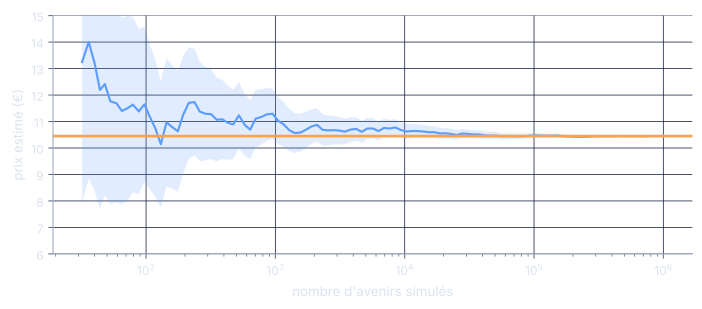
Dans la vidéo, un million d’avenirs donnent 10,46 € avec une erreur typique de 0,015 €, contre 10,45 € pour Black-Scholes. L’intérêt de la simulation n’est pas de retrouver une formule connue : c’est de continuer à marcher quand il n’y en a plus (options sur moyenne, sur plusieurs actifs, modèles à volatilité aléatoire). Le juge sert à valider la méthode sur le cas où il existe.
1.4.3 Cas d’assurance : la ruine#
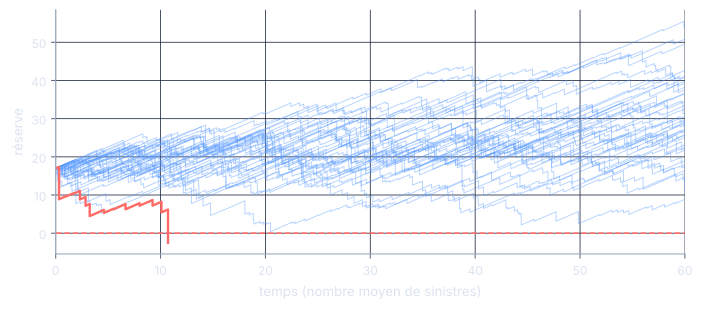
Le modèle de Cramér-Lundberg décrit la réserve d’un assureur : où est la réserve initiale, le taux de primes, un processus de Poisson d’intensité (les dates des sinistres) et des montants i.i.d. de moyenne , indépendants de . La prime contient un chargement de sécurité : . La probabilité de ruine est , encore une espérance d’indicatrice.
Si les montants sont exponentiels de moyenne , alors .
La démonstration (par renouvellement, ou par la martingale exponentielle de Lundberg) est classique (Asmussen et Albrecher 2010, IV). Elle fournit le juge orange de la vidéo.
Pour simuler, on remarque que la réserve ne peut passer sous zéro qu’à l’instant d’un sinistre. En notant les durées entre sinistres (exponentielles de paramètre ), la réserve juste après le -ième sinistre est la marche aléatoire , et la ruine est l’événement . On tronque l’horizon à sinistres.
def ruine(rng, N, u, theta, n_sinistres=1000):
    """Cramér-Lundberg (λ = 1, sinistres Exp de moyenne 1, c = 1 + θ) : ruine avant n_sinistres, et réserve finale."""
    R = np.full(N, float(u))
    ruinee = np.zeros(N, dtype=bool)
    for _ in range(n_sinistres):
        R += (1 + theta) * rng.exponential(1.0, N) - rng.exponential(1.0, N)
        ruinee |= R < 0
    return ruinee, R

ruinee, R = ruine(np.random.default_rng(1903), 10_000, u=17, theta=0.2)
p, demi = monte_carlo(ruinee)
print(f"ruine simulée : {p:.4f} ± {demi:.4f}   |   exacte : {ruine_exacte(17, 0.2):.4f}")
ruine simulée : 0.0501 ± 0.0043 | exacte : 0.0490Ce sont exactement les tirages de la vidéo (même graine, même ordre) : 501 ruines sur 10 000, soit 5,01 % ± 0,43 %, contre 4,90 % exactement.
Démonstration
Le biais de troncature se mesure. L’estimateur vise , pas . Par la propriété de Markov forte, l’écart vaut , que l’on estime sur les mêmes trajectoires grâce à la formule exacte de : on trouve environ , négligeable devant l’erreur statistique. Prédire, simuler, vérifier : même les approximations de l’algorithme se contrôlent.
1.5 Combien de tirages ?#
1.5.1 Le résultat est lui-même au hasard#
Trois estimations de avec 1 000 points chacune donnent 3,140, 3,204 et 3,128 : l’estimateur est une variable aléatoire. Sa loi décrit l’erreur. La loi faible donnait une borne ; le théorème central limite en donne la forme.
Soit un échantillon avec , et . Alors
Démonstration
Posons , centrées réduites, et . Comme , on peut dériver deux fois sous l’espérance (convergence dominée) : est de classe , avec , , , d’où . Par indépendance, la fonction caractéristique de est .
Lemme. Si sont des complexes de module au plus 1, alors (récurrence sur : ).
Pour fixé et , on applique le lemme à et : Comme , la fonction caractéristique de converge vers celle de en tout point, et le théorème de continuité de Lévy (Durrett 2019, paragr. 3.3) donne la convergence en loi.
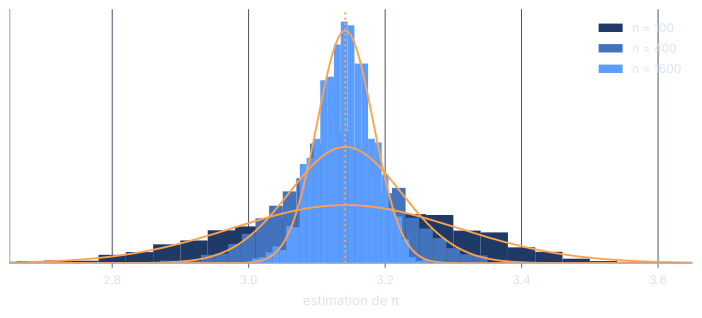
Pour l’estimateur de , un tirage vaut , d’écart-type 1,642 avec . Les écarts-types mesurés sur 2 000 répétitions dans la vidéo sont :
| points | écart-type mesuré | prédit |
|---|---|---|
| 100 | 0,1637 | 0,1642 |
| 400 | 0,0808 | 0,0821 |
| 1 600 | 0,0412 | 0,0411 |
| 10 000 | 0,0164 | 0,0164 |
Quatre fois plus de points divisent l’erreur par deux ; cent fois plus de points font gagner une décimale. C’est la règle d’or de la méthode, et la raison pour laquelle les décimales de arrivaient si lentement à la Section 1.3.
1.5.2 L’intervalle de confiance#
En pratique est inconnu : on le remplace par l’écart-type empirique , qui converge presque sûrement vers (loi forte appliquée aux et aux ). Le passage est justifié par le lemme suivant.
Si en loi et en probabilité ( constante), alors en loi.
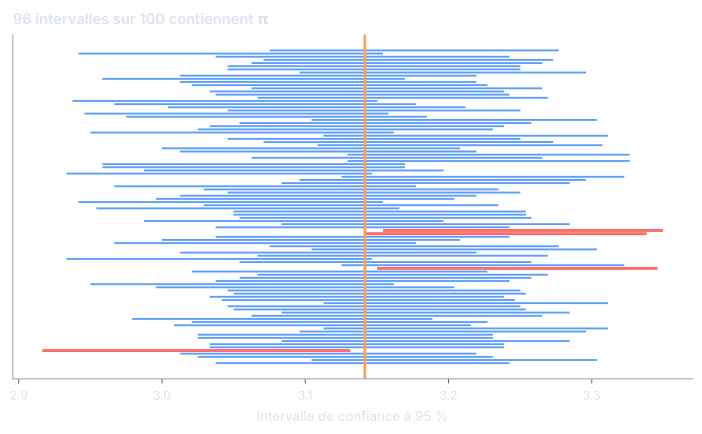
Sous les hypothèses du Théorème 1.4, pour et , Pour , : c’est l’intervalle « estimation ».
Démonstration
p.s., donc en probabilité ; par le Lemme 1.2 et le Théorème 1.4, en loi. L’événement considéré est ; la loi limite ne charge pas le bord , donc .
1.5.3 La réponse à Ulam#
Pour une proportion, . Avec parties, la demi-largeur de l’intervalle à 95 % est donc au plus : avec cent parties, Ulam connaissait sa chance à 9,8 points près au pire. Pour descendre à , il faut Diviser l’erreur par dix coûte cent fois plus de tirages : le prix d’une décimale.
Démonstration
Une garantie non asymptotique. Le Théorème 1.5 est asymptotique. Pour des variables bornées dans , l’inégalité de Hoeffding (Hoeffding 1963) donne une garantie valable pour tout : . Pour Ulam (), une erreur d’au plus 1 % avec probabilité au moins 95 % est garantie dès , soit 18 445 parties : le prix de la certitude est environ le double du prix asymptotique.
1.6 Pourquoi la finance l’adore#
1.6.1 La dimension#
Pour calculer une intégrale sur , on peut aussi quadriller : points par axe, points en tout. Pour une fonction de classe , la règle du point milieu a une erreur en (développement de Taylor à l’ordre 2 dans chaque case : le terme d’ordre 1 s’annule par symétrie). Monte-Carlo a une erreur en , quel que soit . La grille gagne en dimension 1, 2 ou 3 ; elle perd dès , et elle devient impraticable bien avant : dix points par axe en dimension 50 font points, l’ordre de grandeur du nombre d’atomes de la Terre. C’est la malédiction de la dimension.
| dimension | 1 | 2 | 3 | 10 | 50 |
|---|---|---|---|---|---|
| points d’une grille à 10 points par axe | 10 | 100 | 1 000 | ||
| erreur de Monte-Carlo pour tirages |
En finance, la dimension est le nombre de quantités aléatoires d’un scénario : une trajectoire de 48 pas compte 48 dimensions, un portefeuille de 50 actions sur 12 mois en compte 600. C’est la vraie raison du succès de la méthode. La constante , elle, peut dépendre de : c’est l’objet de la séance 2 (la réduire) et du défi 2 du TP.
1.6.2 Le talon d’Achille : l’événement rare#
Pour une probabilité petite, l’erreur relative de vaut qui ne dépend que du nombre d’événements observés. Pour une erreur relative de 10 %, il faut observer environ cent événements, donc tirages. Prenons un assureur assez bien doté pour que sa ruine n’arrive, un jour, qu’environ une fois sur deux cents : dans le modèle de la Section 1.4, une réserve initiale donne une probabilité de ruine exacte de 0,475 %. C’est l’ordre de grandeur de la directive Solvabilité II, qui calibre le capital d’un assureur pour que sa ruine à un an n’ait que 0,5 % de chances de survenir (Parlement européen et Conseil 2009) ; mais ce sont deux probabilités différentes : la directive regarde une seule année, le modèle regarde tout l’avenir. Avec 100 simulations, on n’observe aucune ruine avec probabilité 0,62. Avec 1 000 simulations, la vidéo en observe 6 : 0,6 % ± 0,5 %, presque rien ; il en faut cent mille pour obtenir 0,49 % ± 0,04 %. La séance 3 apprendra à viser là où ça compte.
1.6.3 Repères historiques#
Fermi pratiquait déjà l’échantillonnage statistique à Rome au début des années 1930, sans publier ; Ulam n’invente pas l’idée, il la marie à l’ordinateur.
Le 11 mars 1947, von Neumann envoie à Robert Richtmyer, à Los Alamos, un plan de calcul statistique de la diffusion des neutrons (Eckhardt 1987). Les premières simulations tournent sur l’ENIAC au printemps 1948 ; Klára Dán von Neumann en écrit l’essentiel des programmes (Haigh et al. 2014). Le premier article, « The Monte Carlo Method », paraît en 1949 (Metropolis et Ulam 1949). En finance, Phelim Boyle introduit la simulation dans l’évaluation des options en 1977 (Boyle 1977).
1.7 Ce qu’on retient#
- Une probabilité est une proportion : presque sûrement (loi forte des grands nombres) ; le hasard ne compense pas, il se dilue.
- Une espérance est une moyenne, et une moyenne se simule : , sans biais, de variance .
- L’erreur décroît en : une décimale coûte cent fois plus de tirages ; on rend toujours l’estimation avec son intervalle , qui contient la vraie valeur 95 fois sur cent.
Le programme de la vidéo, en sept lignes, exécuté ici :
import numpy as np
rng = np.random.default_rng(21)
x, y = rng.random(1_000_000), rng.random(1_000_000)
dedans = (x**2 + y**2 <= 1)
pi_hat = 4 * dedans.mean()
erreur = 1.96 * 4 * dedans.std() / 1000
print(round(pi_hat, 4), '±', round(erreur, 4))
3.1407 ± 0.0032Pour s’entraîner#
- Montrer que l’estimateur de Buffon-Laplace est biaisé (inégalité de Jensen), puis calculer son erreur typique par la méthode delta. Comparer, à nombre égal de tirages, à l’estimateur des fléchettes.
- On estime avec tirages. Combien en faut-il pour une erreur relative de 10 % (à 95 %) si ? si ?
- Écrire l’algorithme de simulation de la ruine en temps continu (dates des sinistres comprises) et vérifier qu’il donne la même probabilité que la marche aléatoire . Pourquoi ?
- Montrer que pour des à valeurs dans , .
Pour aller plus loin#
- Vitesse dans le théorème central limite. L’inégalité de Berry-Esseen borne l’écart entre la loi de l’erreur normalisée et par : la cloche est atteinte d’autant plus vite que la loi de est peu asymétrique (Durrett 2019).
- Intervalles pour une proportion. Quand est petit, l’intervalle de Wald couvre mal (il vaut quand aucun succès n’est observé) ; les intervalles de Wilson et de Clopper-Pearson y remédient.
- Quasi-Monte-Carlo. Remplacer les tirages aléatoires par des suites à faible discrépance (Sobol, Halton) donne une erreur proche de pour des intégrandes régulières, au prix d’une estimation d’erreur plus délicate (Glasserman 2004, chap. 5).
- Lectures. Glasserman (2004) (chap. 1 et 2) pour la finance, Asmussen et Glynn (2007) pour la théorie générale, Lapeyre et al. (1998) en français, Owen (2013) en accès libre.
Références citées
- Asmussen, Søren, et Hansjörg Albrecher. 2010. Ruin Probabilities. 2ᵉ éd. World Scientific.
- Asmussen, Søren, et Peter W. Glynn. 2007. Stochastic Simulation: Algorithms and Analysis. Springer.
- Black, Fischer, et Myron Scholes. 1973. « The Pricing of Options and Corporate Liabilities ». Journal of Political Economy 81 (3): 637‑54.
- Boyle, Phelim P. 1977. « Options: A Monte Carlo Approach ». Journal of Financial Economics 4 (3): 323‑38.
- Buffon, Georges-Louis Leclerc. 1777. Essai d’arithmétique morale. IV. Supplément à l’Histoire naturelle. Imprimerie royale.
- Durrett, Rick. 2019. Probability: Theory and Examples. 5ᵉ éd. Cambridge University Press.
- Eckhardt, Roger. 1987. « Stan Ulam, John von Neumann, and the Monte Carlo Method ». Los Alamos Science 15: 131‑37.
- Etemadi, Nasrollah. 1981. « An Elementary Proof of the Strong Law of Large Numbers ». Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete 55: 119‑22.
- Glasserman, Paul. 2004. Monte Carlo Methods in Financial Engineering. Springer.
- Haigh, Thomas, Mark Priestley, et Crispin Rope. 2014. « Los Alamos Bets on ENIAC: Nuclear Monte Carlo Simulations, 1947–1948 ». IEEE Annals of the History of Computing 36 (3): 42‑63.
- Hoeffding, Wassily. 1963. « Probability Inequalities for Sums of Bounded Random Variables ». Journal of the American Statistical Association 58 (301): 13‑30.
- Hoekstra, Rink, Richard D. Morey, Jeffrey N. Rouder, et Eric-Jan Wagenmakers. 2014. « Robust Misinterpretation of Confidence Intervals ». Psychonomic Bulletin & Review 21 (5): 1157‑64.
- Lapeyre, Bernard, Étienne Pardoux, et Rémi Sentis. 1998. Méthodes de Monte-Carlo pour les équations de transport et de diffusion. Vol. 29. Mathématiques et Applications. Springer.
- Laplace, Pierre-Simon. 1812. Théorie analytique des probabilités. Courcier.
- Merton, Robert C. 1973. « Theory of Rational Option Pricing ». Bell Journal of Economics and Management Science 4 (1): 141‑83.
- Metropolis, Nicholas. 1987. « The Beginning of the Monte Carlo Method ». Los Alamos Science 15: 125‑30.
- Metropolis, Nicholas, et Stanislaw Ulam. 1949. « The Monte Carlo Method ». Journal of the American Statistical Association 44 (247): 335‑41. https://doi.org/10.1080/01621459.1949.10483310.
- O’Neill, Melissa E. 2014. PCG: A Family of Simple Fast Space-Efficient Statistically Good Algorithms for Random Number Generation. HMC-CS-2014-0905. Harvey Mudd College.
- Owen, Art B. 2013. Monte Carlo Theory, Methods and Examples.
- Parlement européen et Conseil. 2009. Directive 2009/138/CE sur l’accès aux activités de l’assurance et de la réassurance et leur exercice (Solvabilité II), article 101. Journal officiel de l’Union européenne, L 335.
- Tversky, Amos, et Daniel Kahneman. 1974. « Judgment under Uncertainty: Heuristics and Biases ». Science 185 (4157): 1124‑31.